IMRaD Analyzer خدمة سحابية لتحليل المقالات بالذكاء الاصطناعي
ذكاء اصطناعي يقرأ المقالات العلمية، بحسابات مجانية ومميزة.
الحاجة
مساعدة الباحثين على فهم بنية المقدمة جملة بجملة دون إعادة قراءة كل شيء.
ما بنيناه
خدمة على الإنترنت مع رفع ملفات PDF وتحليل بالذكاء الاصطناعي وسجل ولوحة إدارة واشتراكات مجانية ومميزة.
- Next.js
- FastAPI
- BERT
- Gemini
النتائج
- 98,21 %
- دقة (F1)
- 169 000
- جملة مصنفة
- 3
- مستويات وصول
ما يفعله التطبيق، شاشة بشاشة
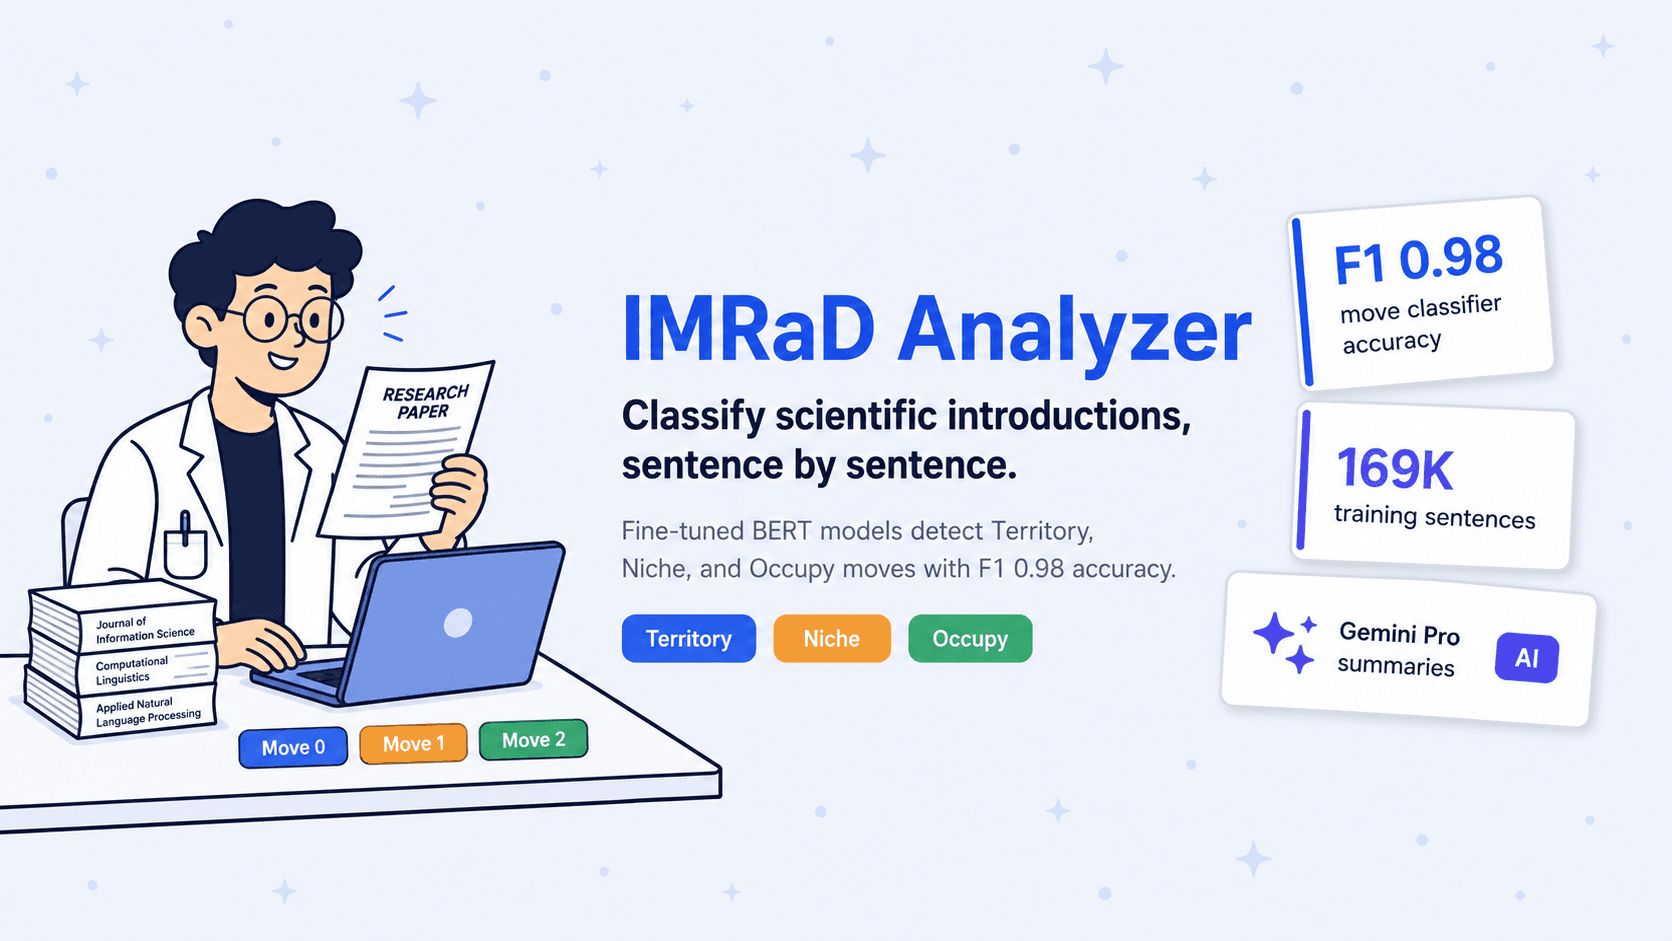
صورة تعريفية لـ IMRaD Analyzer
- سلسلة من نماذج BERT المدرّبة تصنّف كل جملة في مقدمة علمية إلى حركة: الإقليم أو الفجوة أو الإشغال.
- مجموعة بيانات من 169 ألف جملة بُنيت بخط معالجة Gemini Pro من 3 مراحل، وبلغت أعلى قيمة F1 فيها 98.21%.
- معمارية موزعة من 8 خدمات مصغّرة تتولى استخراج PDF والتصنيف والتحليل بالذكاء الاصطناعي وإدارة المستخدمين.
معمارية من 8 خدمات مصغّرة
- Nginx (بوابة)
- Spring Cloud Eureka (اكتشاف الخدمات)
- Next.js (الواجهة وواجهة البرمجة)
- مستخرج PDF (FastAPI)
- TensorFlow Serving
- خدمات الذكاء الاصطناعي للحركات والحركات الفرعية (FastAPI مع LangChain)
- خدمة بيانات المستخدمين (MongoDB وExpress.js)
- Redis وسيطًا للرسائل.
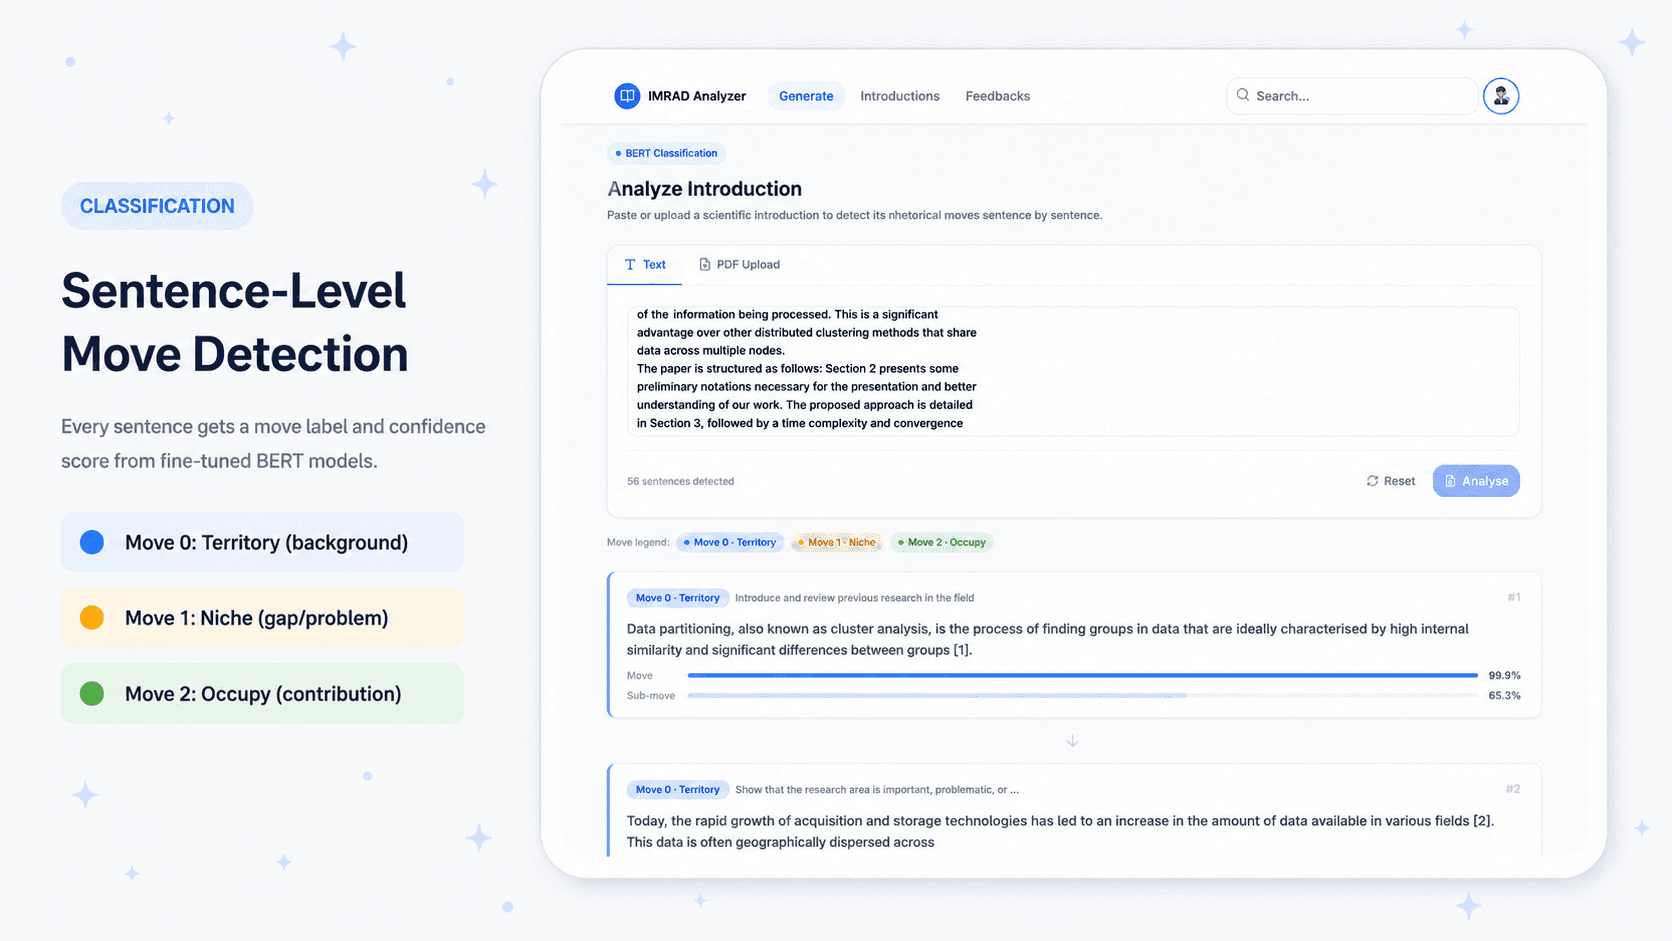
كشف الحركات جملةً بجملة
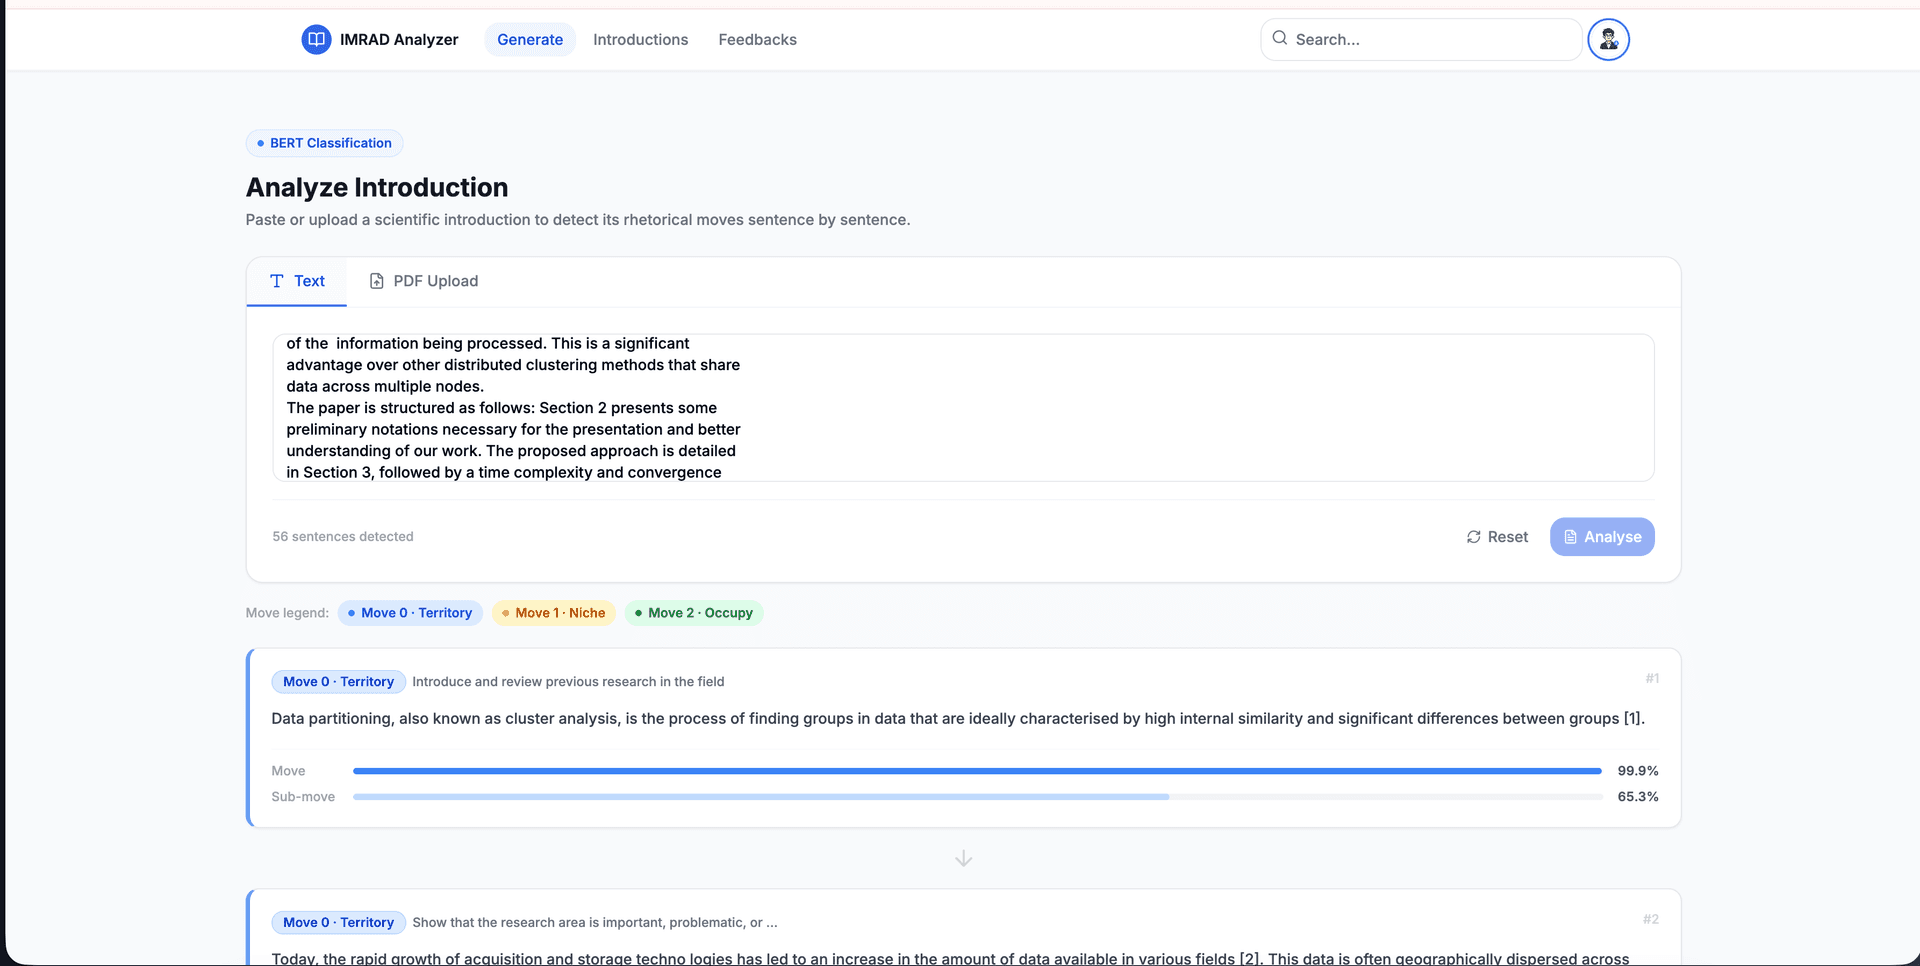
- كل جملة في مقدمة علمية تُوسَم بحركتها في IMRaD (الإقليم / الفجوة / الإشغال) وحركتها الفرعية، مباشرةً.
- شارات ملوّنة (أزرق، كهرماني، أخضر) وشريط ثقة لكل جملة يجعل النتائج مقروءة فورًا.
- سلسلة من أربعة نماذج BERT هرمية مدرّبة، تُقدَّم عبر TensorFlow Serving، تشغّل خط المعالجة كله.
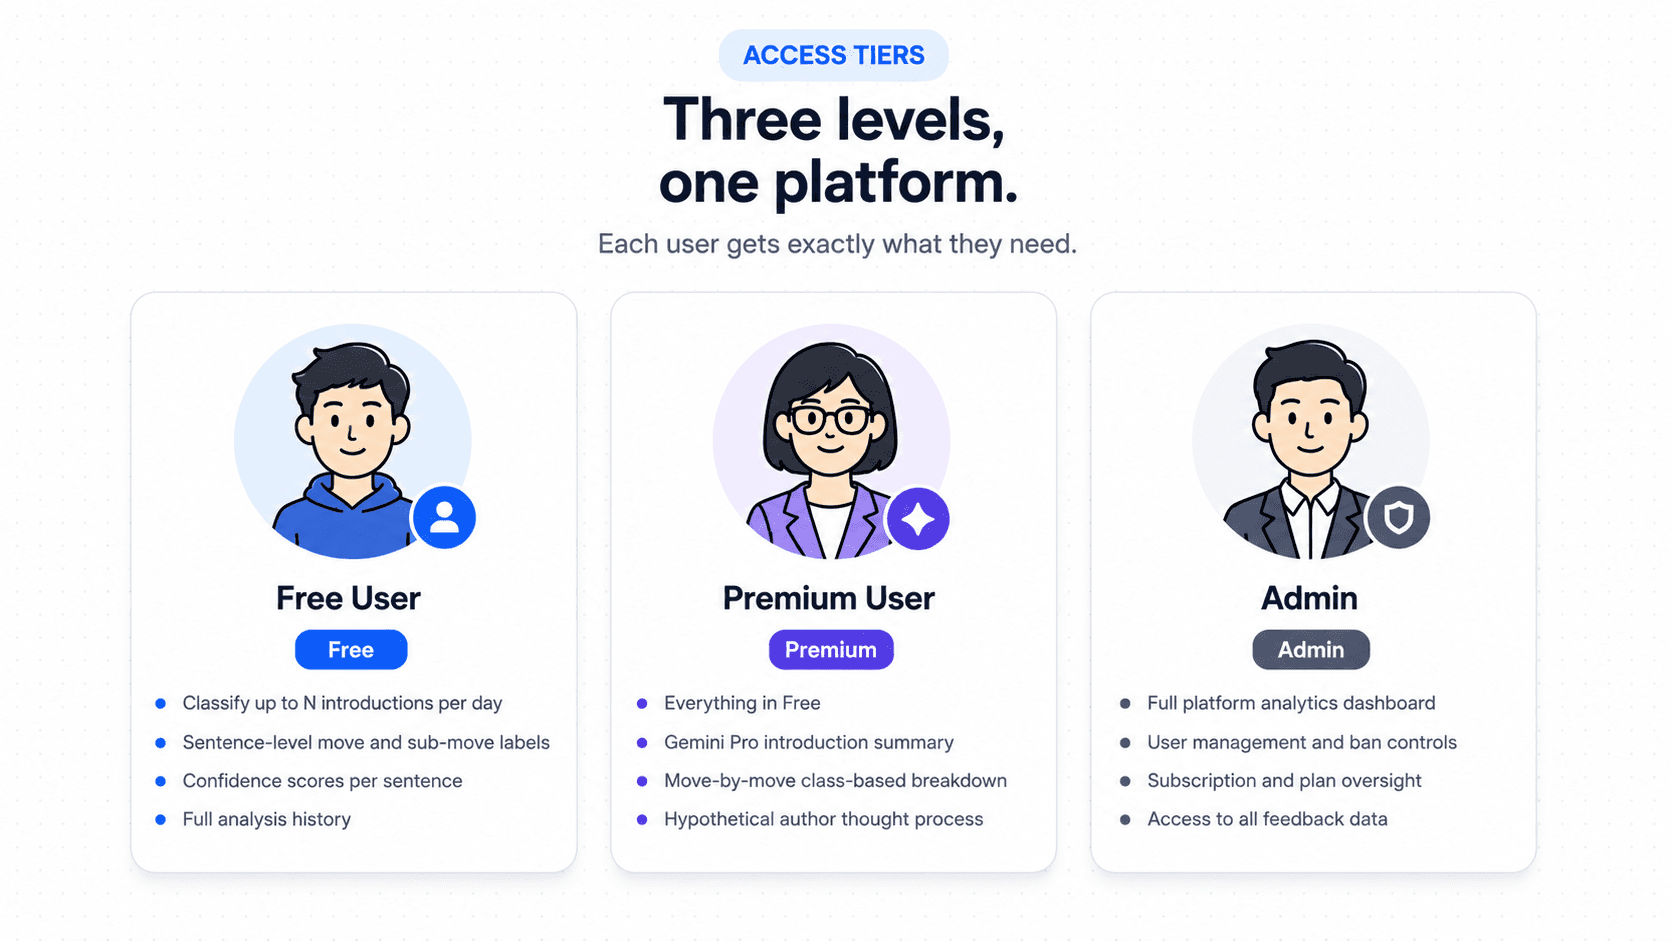
ثلاثة مستويات وصول
- المستخدمون المجانيون يصنّفون المقدمات ويرون وسم كل جملة ودرجة الثقة وسجل تحليلاتهم كاملًا.
- المستخدمون المميزون يحصلون على ملخص Gemini Pro وتحليل حسب الحركة وتصوّر لطريقة تفكير المؤلف.
- المسؤولون لديهم إحصائيات المنصة وإدارة المستخدمين والاشتراكات وكل الملاحظات.
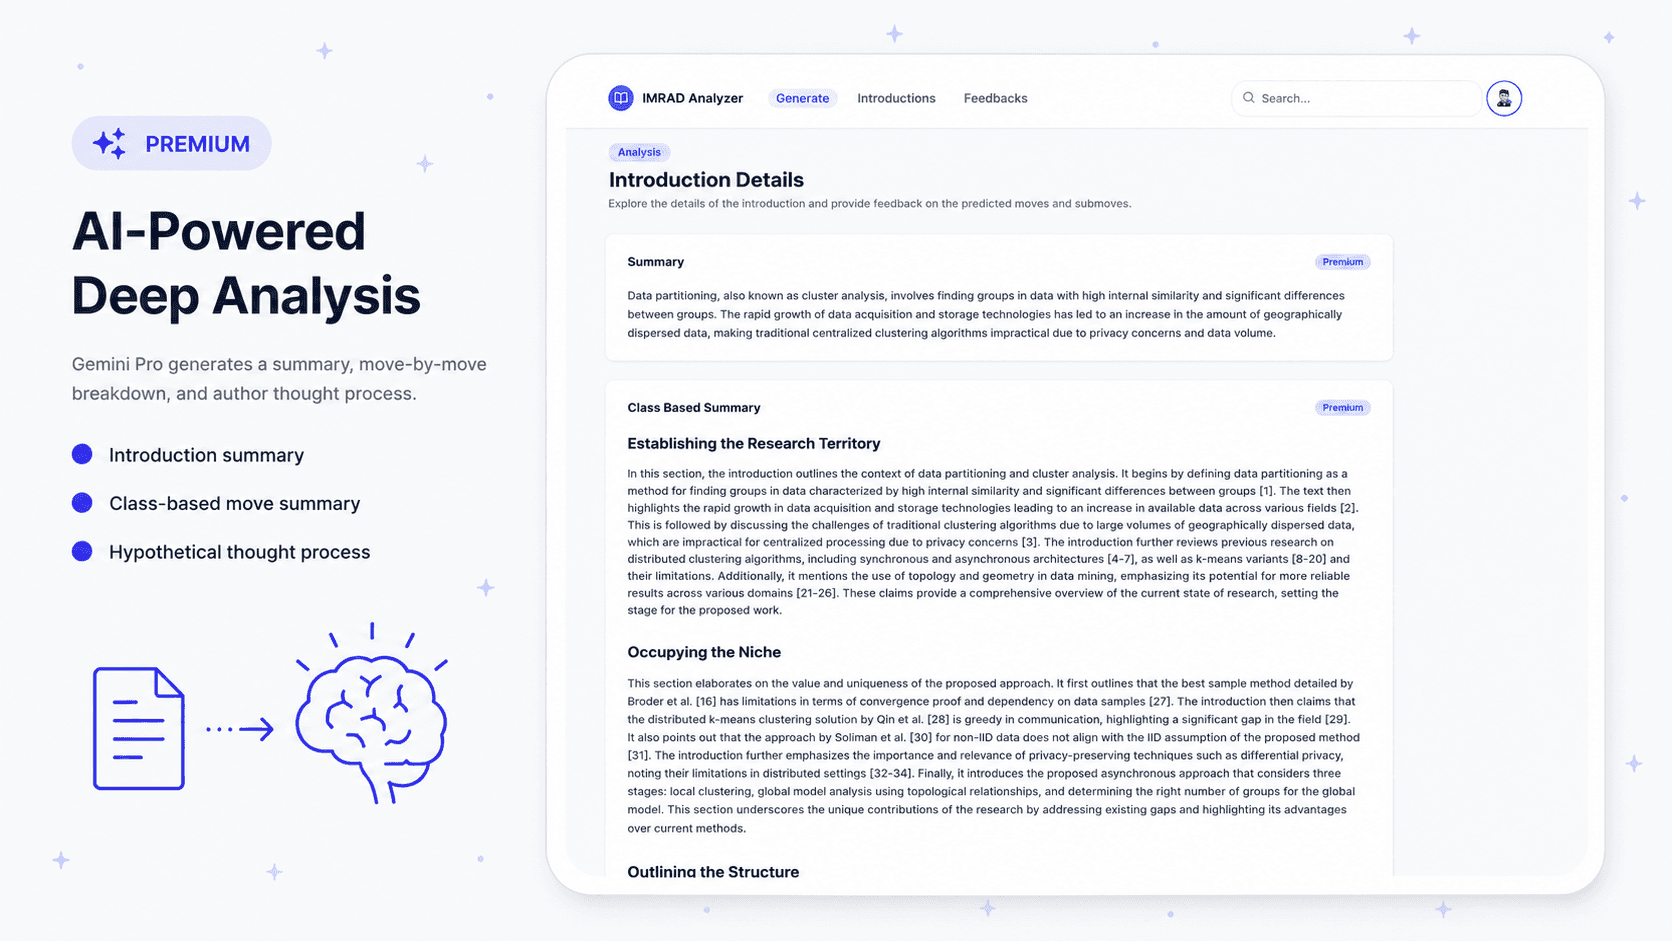
تحليل معمّق بالذكاء الاصطناعي
- المستخدمون المميزون يتلقّون ملخصًا للمقدمة من Gemini Pro وتحليلًا حركةً بحركة وتصوّرًا لطريقة تفكير المؤلف.
- تصل الأقسام الثلاثة تدريجيًا عبر Redis pub/sub، فتظهر النتائج تباعًا دون انتظار.
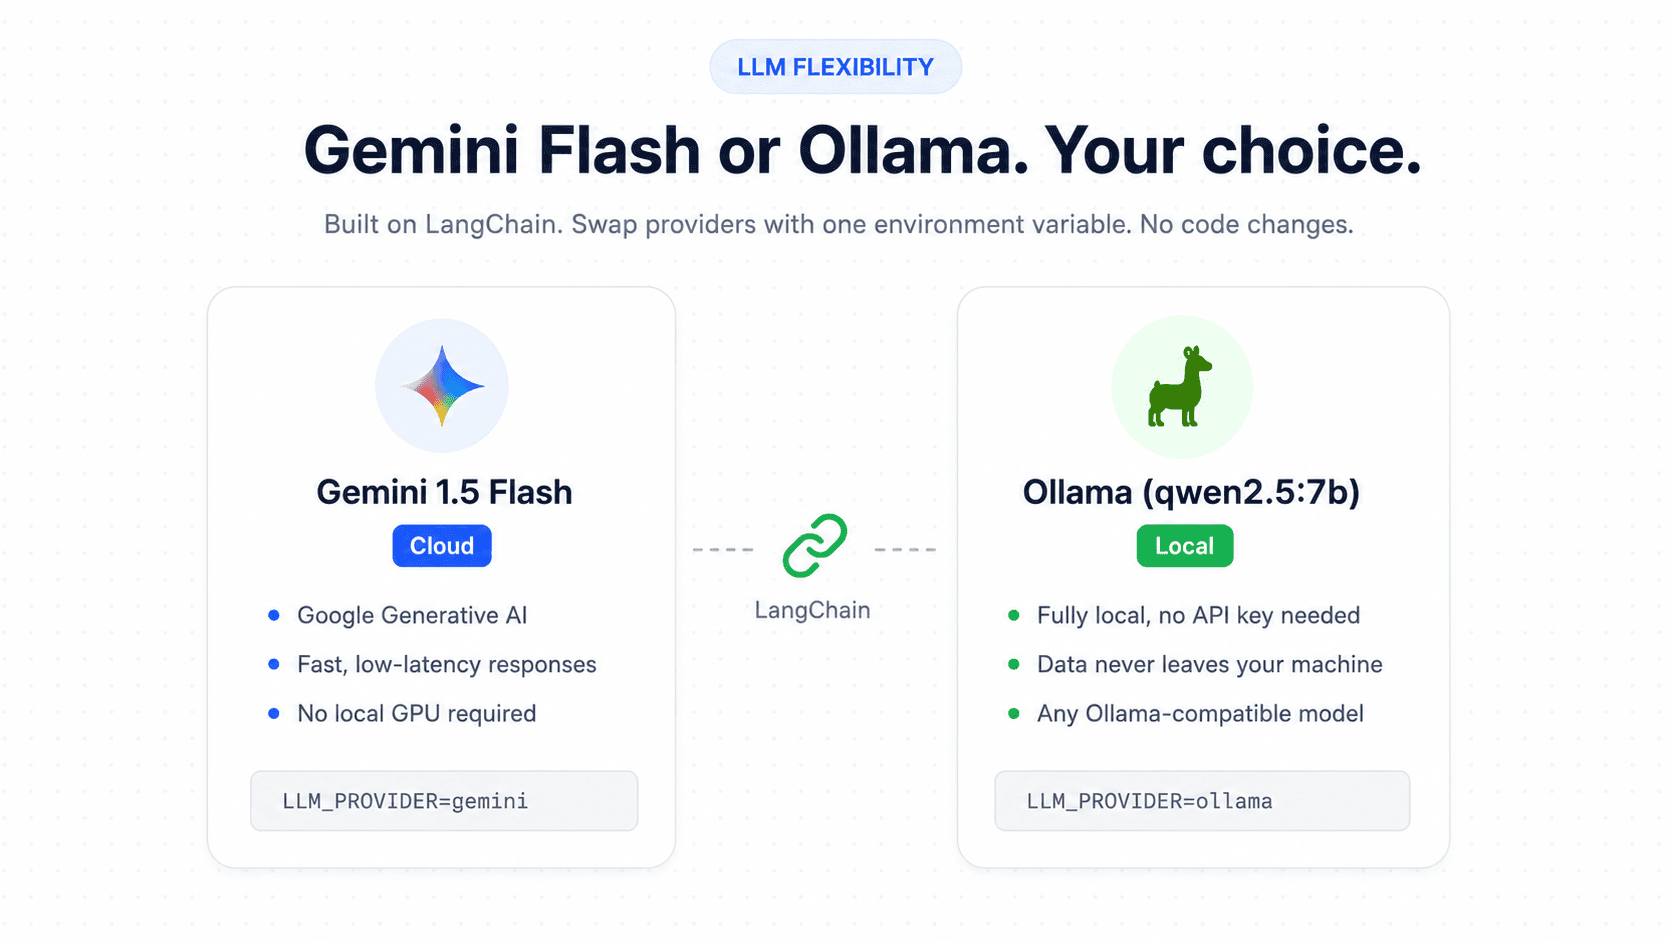
- طبقة الذكاء الاصطناعي مبنية على LangChain، وتنتقل من Gemini Flash إلى نموذج Ollama محلي بالكامل بمتغير بيئة واحد.
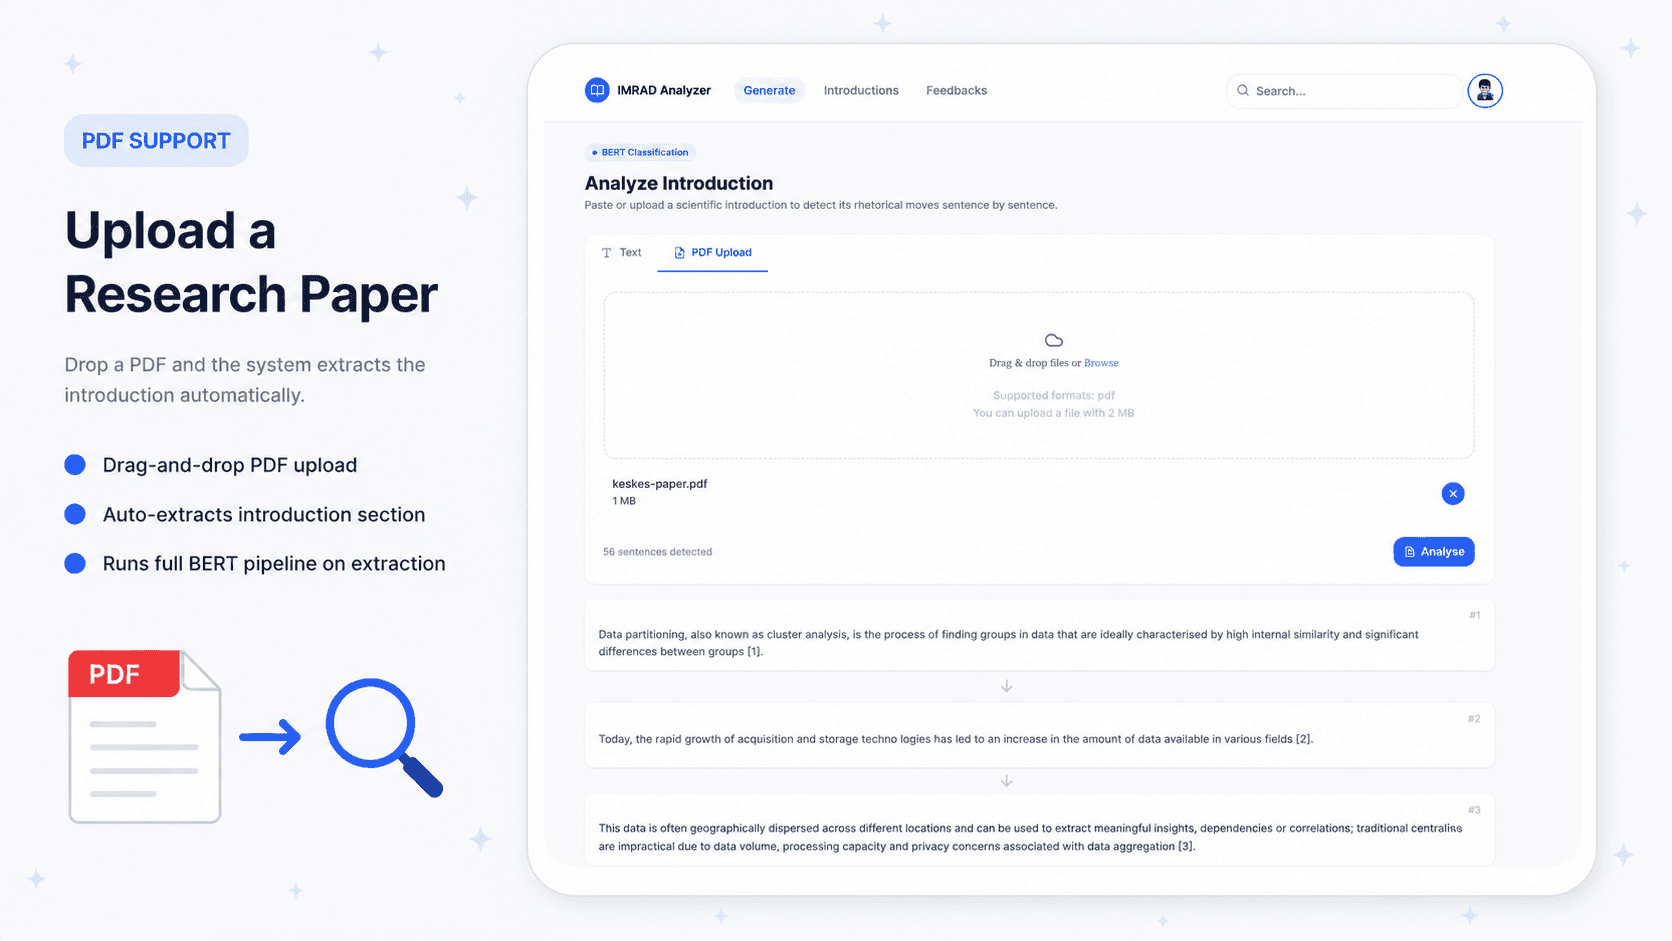
رفع ملفات PDF واستخراجها
- يسحب المستخدم ملف المقال بصيغة PDF ويفلته، فيستخرج النظام المقدمة تلقائيًا.
- خدمة FastAPI مخصّصة تتولى الاستخراج ثم تمرّر النص إلى خط تصنيف BERT.
- يعمل التصنيف جملةً بجملة على المقدمة المستخرجة دون أي نسخ ولصق يدوي.
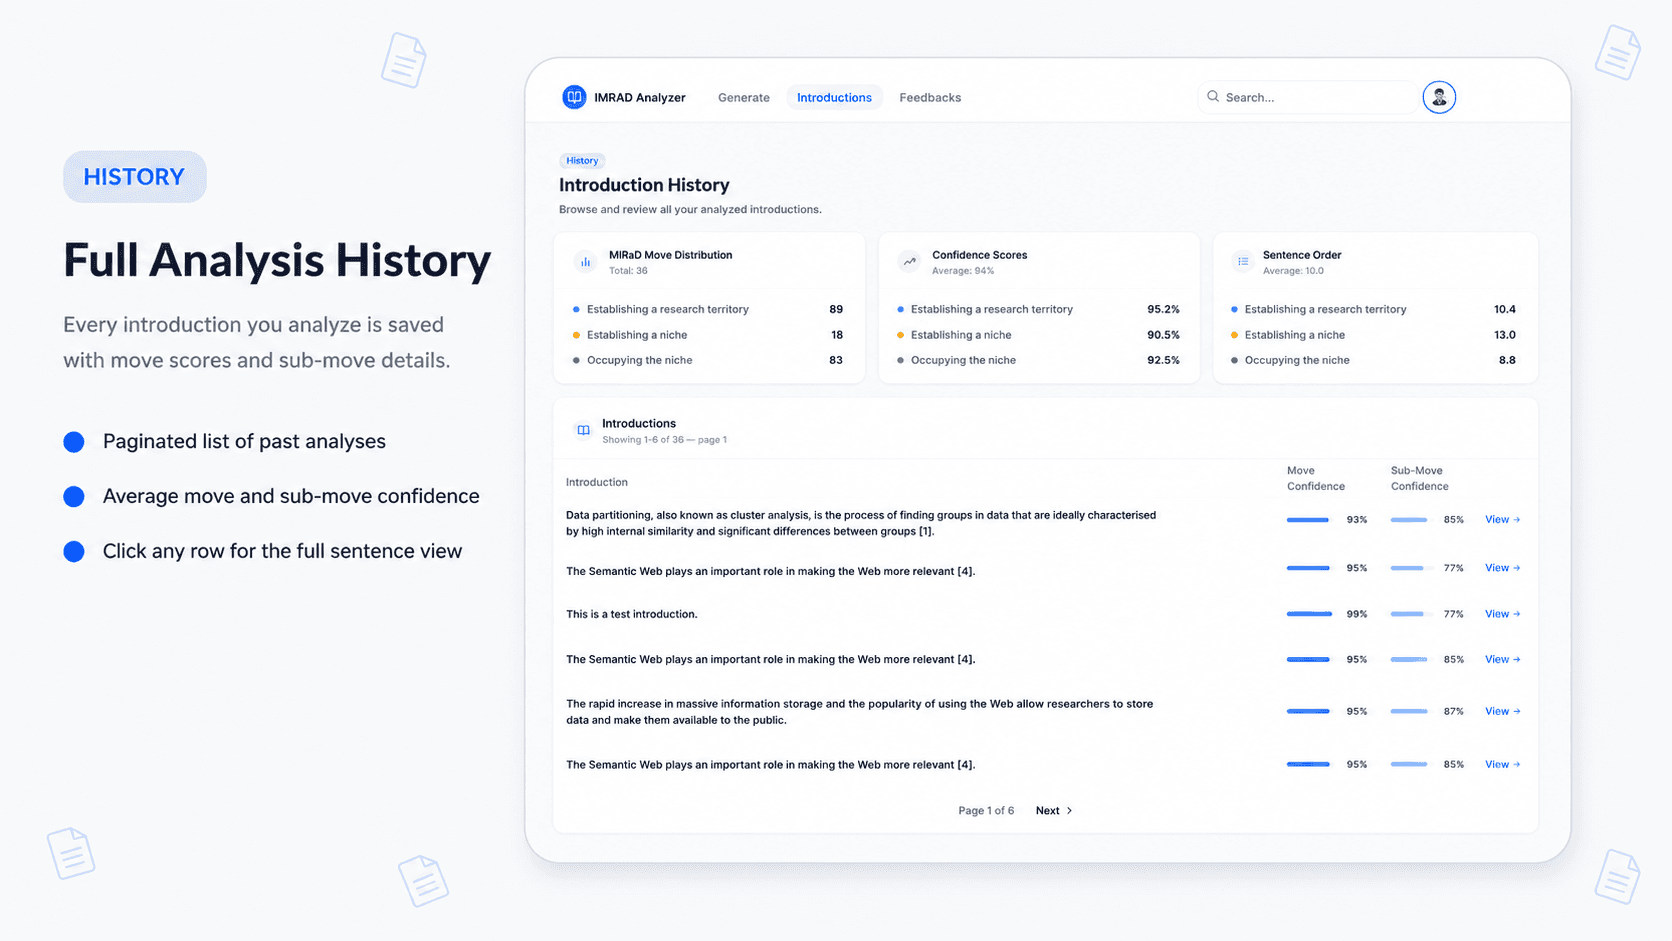
سجل كامل للتحليلات
- تُحفظ كل مقدمة مُحلَّلة مع متوسط درجات الثقة للحركات والحركات الفرعية وتاريخ الإنشاء.
- قائمة مقسّمة إلى صفحات تقود مباشرةً إلى التفصيل جملةً بجملة لكل تحليل سابق.
- يتابع المستخدم مع الوقت كيف تتوزع المقالات المختلفة بين الإقليم والفجوة والإشغال.
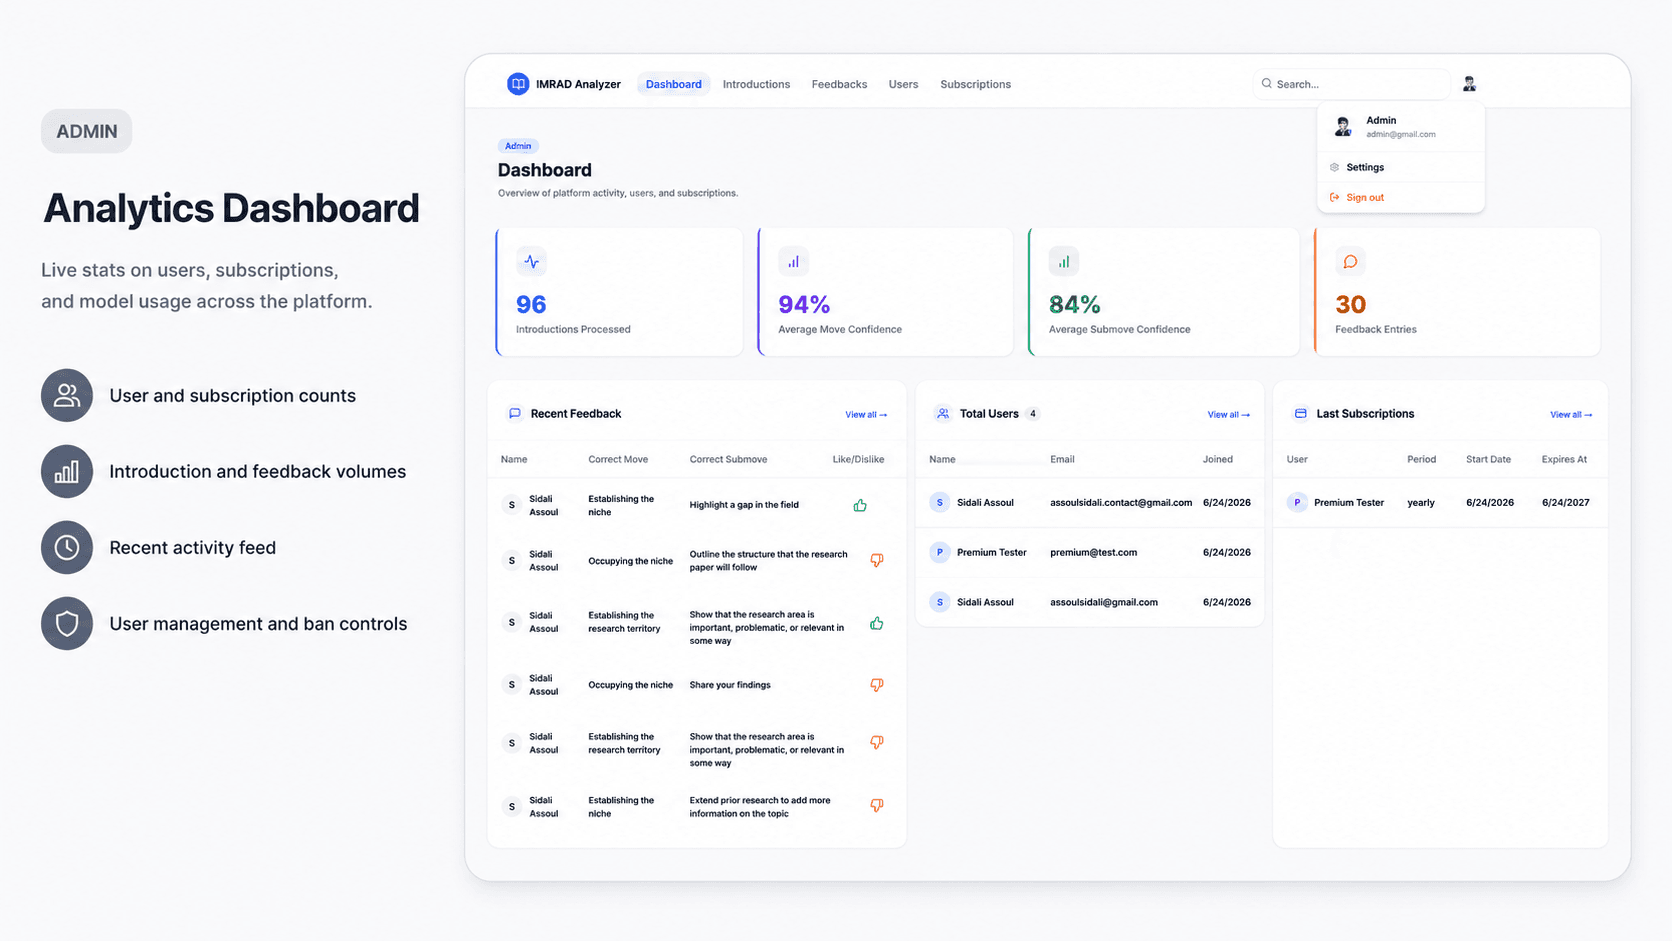
لوحة الإحصائيات
- بطاقات مباشرة تعرض عدد المستخدمين والمشتركين المميزين والمقدمات المحللة والملاحظات المجمّعة.
- رسوم بيانية وسجل نشاط حديث يمنحان المسؤولين صورة آنية عن استخدام المنصة.
- إدارة المستخدمين وحظرهم من الصفحة نفسها.
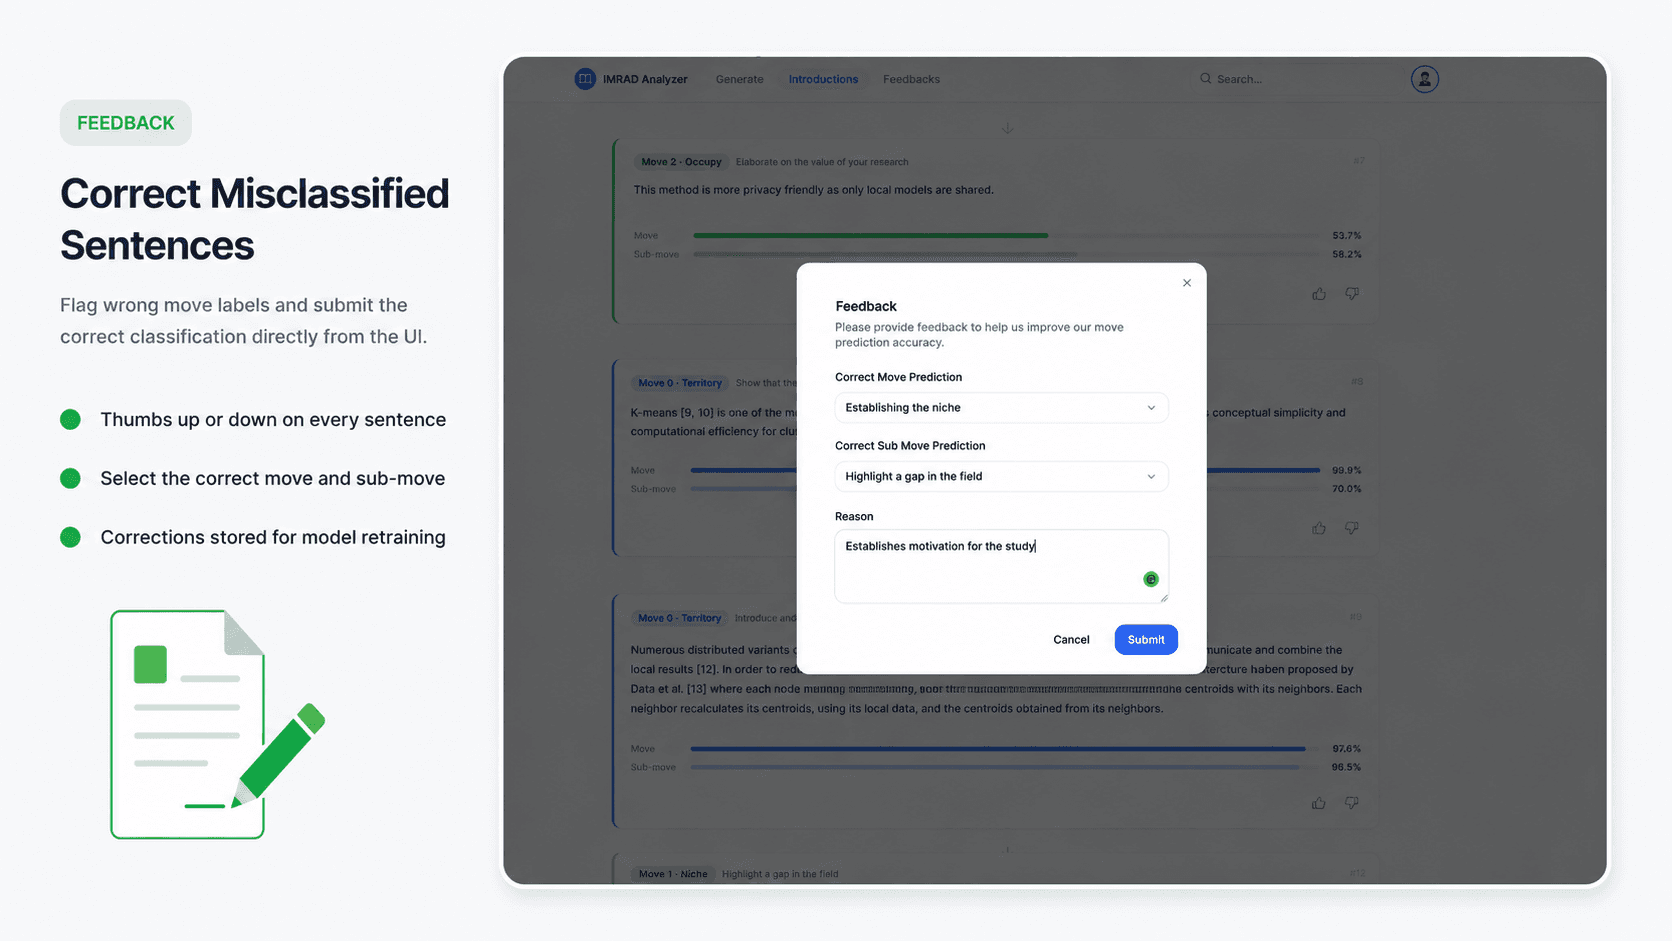
تصحيح الجمل المصنّفة خطأً
- يبلّغ المستخدم عن أي تصنيف خاطئ مباشرةً من صفحة المقدمة بزر الإعجاب أو عدمه.
- نافذة تصحيح تتيح اختيار الحركة والحركة الفرعية الصحيحتين قبل الإرسال.
- يُحفظ كل تصحيح ويعاد إلى خط إعادة تدريب BERT لتحسين جودة النموذج باستمرار.
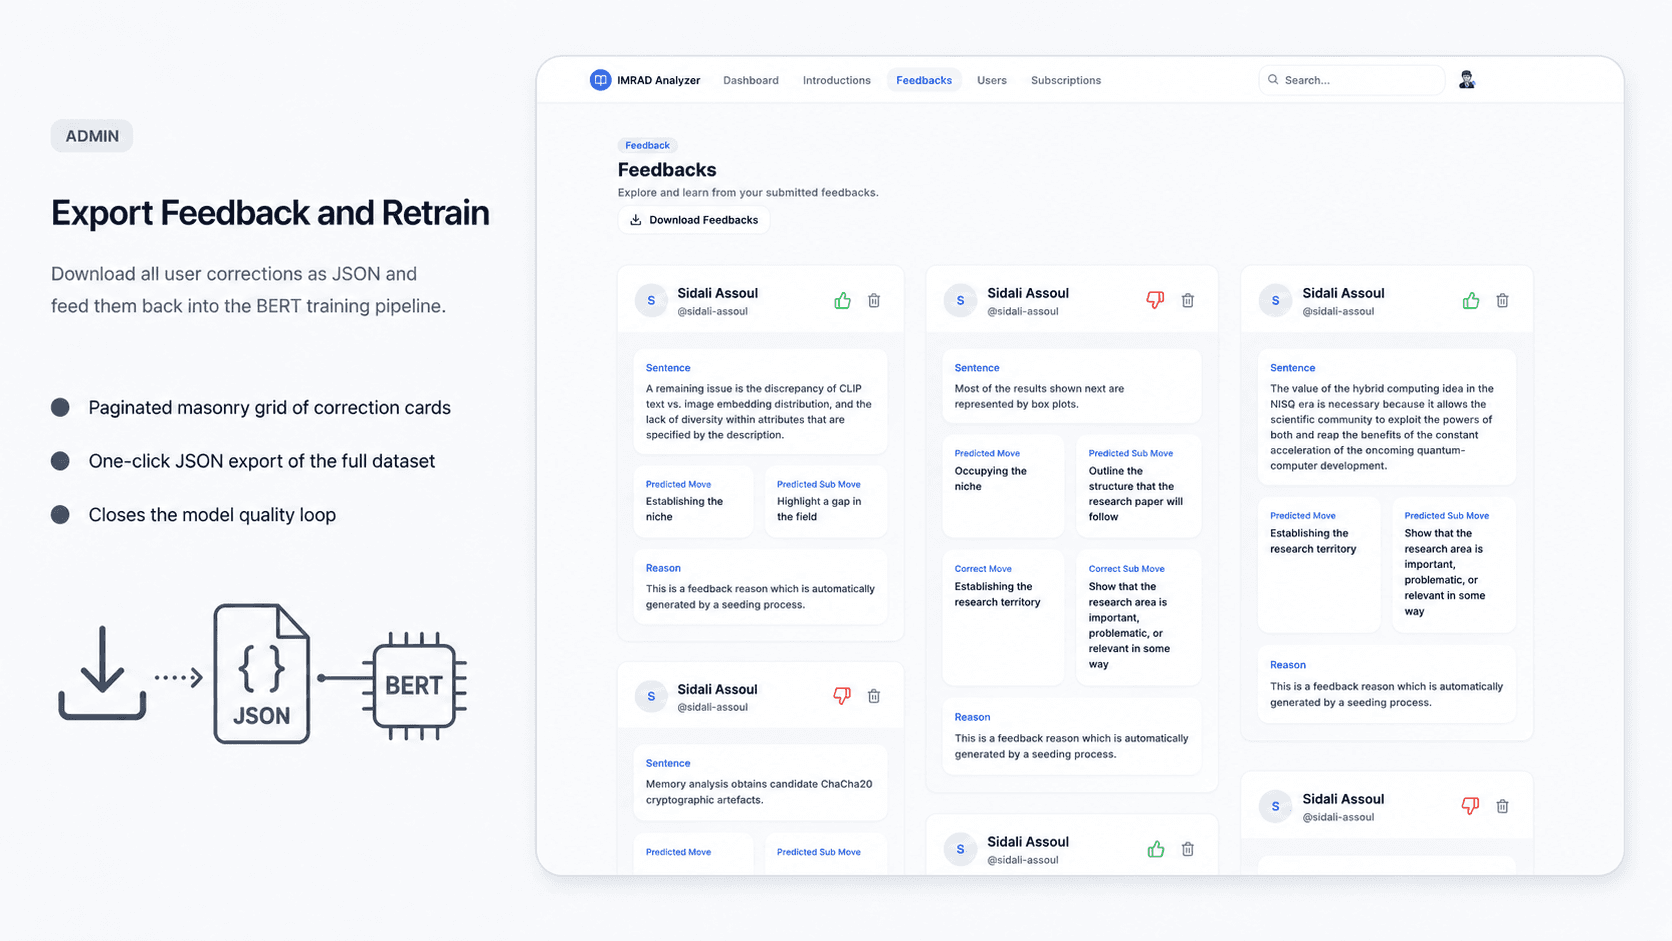
تصدير الملاحظات وإعادة التدريب
- يتصفّح المسؤولون كل تصحيحات المستخدمين في شبكة بطاقات مقسّمة إلى صفحات.
- تصدير بصيغة JSON بنقرة واحدة يحمّل كل التصحيحات لخط تدريب BERT.
- تعود أخطاء التصنيف الحقيقية بذلك إلى ضبط النموذج.
خلفية LLM مرنة عبر LangChain
- طبقة التحليل بالذكاء الاصطناعي مبنية على LangChain مع مزوّدَين يُبدَّل بينهما بمتغير بيئة واحد.
- LLM_PROVIDER=gemini يستعمل Gemini 1.5 Flash عبر واجهة Google، وLLM_PROVIDER=ollama يشغّل الاستدلال محليًا بالكامل.
- لا حاجة لأي تعديل في الشيفرة لتغيير المزوّد، وأي نموذج متوافق مع Ollama يعمل مباشرة.
مشروع مثل هذا؟
صفوه في سطرين على واتساب، ونرد عليكم مباشرة.
المشروع التاليContractsFlow